La visibilité IA passe à côté de la couche des affirmations : 2 862 affirmations auditées
Nous avons audité 2 862 affirmations produit générées par IA et découvert pourquoi les métriques de mention et de citation manquent les erreurs de catégorie, de tarif, de plan gratuit et d'essai.

Les tableaux de bord marketing adorent un chiffre vert unique.
Part de voix. Taux de citation. Sentiment. Une capture d'écran pour la réunion du lundi. Tout le monde approuve. Avec un peu de chance, la réunion se termine même en avance.
Voici le problème : une réponse IA peut mentionner votre marque, citer votre page d'accueil, et pourtant vous placer dans la mauvaise catégorie ou inventer votre prix de départ.
La plupart des tableaux de bord de visibilité considèrent cela comme une victoire. C'est compréhensible : les mentions et les citations sont des événements nets. Pour un acheteur, une mauvaise catégorie ou un mauvais prix reste de la désinformation.
Nous avons réalisé ce benchmark chez Sonarvue parce que nous nous sommes surpris à faire la même substitution. Les métriques au niveau des mentions étaient nettes, comparables et faciles à représenter. Elles ne nous disaient pas si la réponse était fiable pour un acheteur.
Nous avons donc demandé à GPT 5.5, Gemini 3 Flash et Claude Fable 5 de décrire 100 entreprises de logiciels B2B. Leurs 300 réponses ont donné 2 862 affirmations produit individuelles, que nous avons vérifiées par rapport à 1 048 faits extraits des pages officielles de ces entreprises.
Les réponses avec recherche activée ont atteint 98,6 % d'exactitude vérifiée.
Cela donne l'impression que le problème est résolu.
Puis nous avons regardé le dénominateur.
Divulgation : Sonarvue a réalisé ce benchmark à partir de sites d'entreprises publics, pas de données clients. Le jeu de données public au niveau des entreprises est anonymisé.
Téléchargez les résultats agrégés, comparaison des générations, comparaison des sources, risque des sources par champ, données d'entreprises anonymisées, ou résumé JSON public.
La visibilité IA comporte une couche d'affirmations
La plupart des rapports de visibilité IA commencent par trois questions utiles :
- La réponse a-t-elle mentionné la marque ?
- Où la marque est-elle apparue par rapport aux concurrents ?
- Quelles pages la réponse a-t-elle citées ?
Ces questions mesurent la présence. Les acheteurs agissent selon ce que la réponse dit après l'apparition de la marque.
Si une réponse recommande votre entreprise, la qualifie de plateforme de sécurité pour grandes entreprises et indique que les offres démarrent à 49 $, la mention vous dit seulement que vous êtes entré dans la pièce. La catégorie et le prix déterminent si l'acheteur continue d'écouter.
Cela crée une pile de mesure à six couches :
| Couche | Question |
|---|---|
| Présence | La marque a-t-elle été nommée ? |
| Position | Où est-elle apparue par rapport aux concurrents ? |
| Source | Quelle URL le modèle a-t-il rapportée ? |
| Affirmation | Quelle affirmation factuelle le modèle a-t-il formulée ? |
| Preuve | Les preuves actuelles étayent-elles cette affirmation ? |
| Dérive | L'affirmation ou la source a-t-elle changé lors de l'exécution suivante ? |
La part de voix est utile au sommet. Ce n'est pas un outil de débogage.
La couche des affirmations est l'endroit où une métrique marketing devient un système opérationnel. Elle distingue « nous étions invisibles » de « nous étions visibles pour la mauvaise raison ».
Vous n'avez pas besoin de jeter les métriques que vous possédez déjà. Gardez la part de voix comme carte. Pour les requêtes d'acheteurs les plus importantes, ouvrez la réponse brute et inspectez les affirmations sur la catégorie, le prix, l'offre, l'essai et l'intégration qui s'y trouvent.
HackerNoon a récemment couvert une étude portant sur 21 000 citations qui distingue la fréquence de citation de l'influence réelle. Notre benchmark reprend une étape plus loin : même une source influente ne garantit pas que chaque affirmation produit associée soit à jour ou étayée.
Le score d'exactitude était juste et pourtant incomplet
GPT 5.5 et Gemini 3 Flash ont produit 1 999 affirmations dans la partie du test avec recherche activée.
| Verdict | Affirmations | Part |
|---|---|---|
| Étayée | 552 | 27,6 % |
| Contredite | 8 | 0,4 % |
| Non vérifiable | 857 | 42,9 % |
| Non-affirmation ou inconnu explicite | 582 | 29,1 % |
L'exactitude vérifiée utilise les affirmations que nos preuves pouvaient trancher :
552 supported / (552 supported + 8 contradicted) = 98.6%
Le calcul est correct. Il couvre 560 affirmations.
857 autres affirmations substantielles se trouvaient hors de ce dénominateur. Ce n'étaient pas des erreurs, mais elles n'étaient pas confirmées non plus. Lorsque nous avons mesuré la part de la réponse substantielle que les preuves pouvaient trancher, la couverture est tombée à 39,5 %.
Cela donne au marketing et à l'ingénierie deux métriques distinctes à piloter :
- L'exactitude vérifiée demande si la réponse était conforme lorsque les preuves capturées pouvaient en juger.
- La couverture des preuves demande quelle part de la réponse substantielle les preuves pouvaient juger tout court.
Nous traitons « non vérifiable » comme un état non résolu explicite, et non comme une étiquette d'échec atténuée. L'élément de preuve peut exister en dehors du crawl délimité. Le site officiel peut omettre le détail. Le modèle peut l'avoir inventé. Un pipeline fiable préserve cette incertitude au lieu de la blanchir en score.
Pour un marketeur, cela signifie que le titre de 98,6 % ne peut pas figurer seul dans un rapport.
Pour un ingénieur, cela signifie que not_verifiable appartient au schéma comme verdict de premier ordre. Pour la personne qui lit le rapport, la couverture des preuves devrait figurer à côté de l'exactitude, afin que personne n'ait à reconstituer ce que le score a exclu.
l'audit de la recherche générative de Liu, Zhang et Liang établit une distinction similaire entre l'exhaustivité des citations et leur exactitude. Une réponse cite-t-elle suffisamment d'affirmations, et chaque citation étaye-t-elle la phrase associée ? Nos données montrent pourquoi le dénominateur doit accompagner le score d'exactitude.
Les citations sont de la télémétrie, pas une vérité de référence
GPT 5.5 a rapporté une source pour chacune de ses 775 assertions substantielles. Gemini 3 Flash en a rapporté une pour 641 sur 642.
Excellente couverture des sources. Ce n'est toujours pas une preuve.
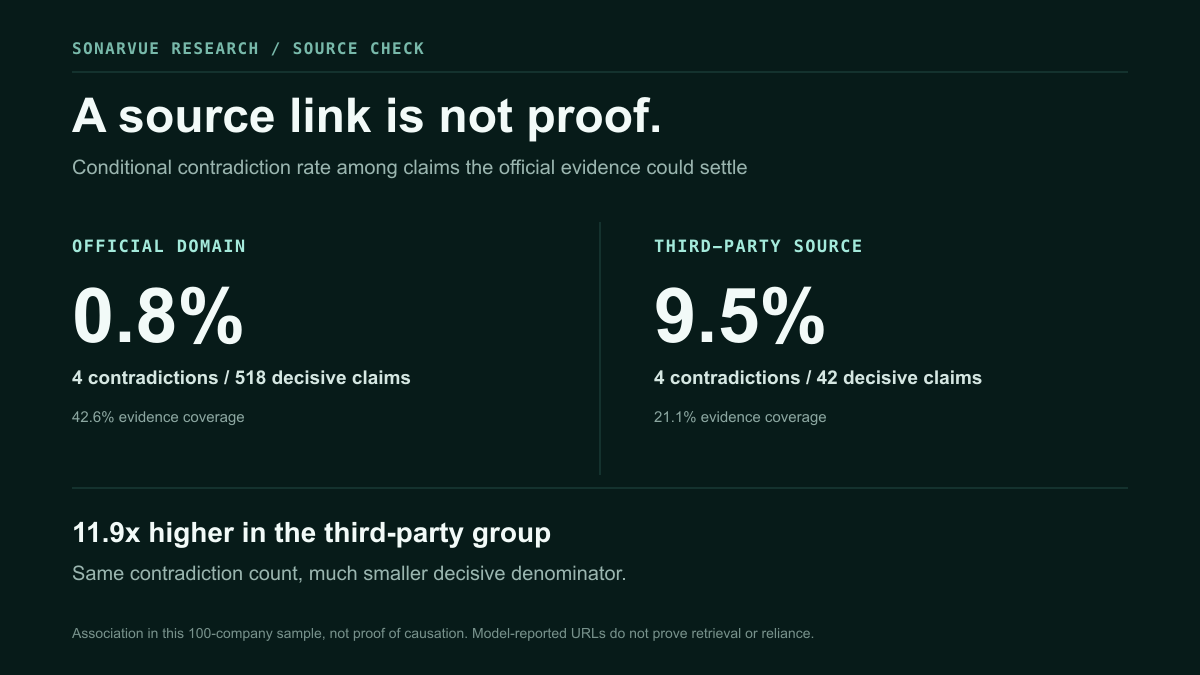
Nous avons réparti les affirmations selon le type de source rapportée. Les affirmations issues de domaines officiels ont donné 514 affirmations étayées, quatre contradictions et 699 affirmations non résolues. Les affirmations tierces ont donné 38 affirmations étayées, quatre contradictions et 157 affirmations non résolues.
Parmi les affirmations que les preuves pouvaient trancher, le taux de contradiction était de 0,8 % pour les affirmations issues de domaines officiels et de 9,5 % pour les affirmations tierces. Soit un écart d'environ 12x.
La phrase complète est la suivante : les affirmations tierces présentaient un taux de contradiction conditionnel environ 12x plus élevé, d'après quatre contradictions dans chaque groupe de sources. Le multiplicateur est le signal. Les effectifs vous indiquent avec quelle prudence l'utiliser.
La différence de couverture était moins fragile. Les affirmations issues de domaines officiels avaient une couverture de preuves de 42,6 %, contre 21,1 % pour les affirmations tierces.
Il y a un autre piège technique. « Source rapportée » signifie que l'URL est apparue dans la réponse. Nous n'avions pas de télémétrie de navigateur prouvant que le modèle a ouvert cette page, l'a lue et s'est appuyé sur elle pour la phrase adjacente.
Une citation est une télémétrie utile. Ce n'est pas une déclaration notariée.
Allaham et Diakopoulos ont constaté l'apparition de pages générées par IA parmi les citations de recherche générative. Une autre étude portant sur 167 551 citations a constaté que 85,7 % des sources utilisées pour les questions de réputation de marque étaient tierces. Notre requête produit nominative penchait bien davantage vers les domaines officiels.
Des requêtes différentes produisent des marchés de sources différents. Tout tableau de bord qui masque la requête tout en classant les domaines cache la moitié de l'expérience.
Les manquements touchent les faits décisifs pour l'acheteur
Les huit contradictions confirmées n'étaient pas spectaculaires. Personne n'a affirmé qu'un CRM pouvait lancer un satellite.
Elles étaient plus dangereuses que cela. Elles étaient crédibles.
Trois réponses ont confondu l'entreprise elle-même :
- Gemini a décrit Revelation Software comme une plateforme de recherche qualitative en ligne. L'entreprise édite OpenInsight, une suite de développement de bases de données NoSQL MultiValue.
- Gemini a décrit Shared comme un éditeur en ligne. Shared vend un système d'exploitation en marque blanche pour les entreprises de commande en ligne.
- Gemini a traité Helm Operations comme une plateforme de déploiement Kubernetes. Elle vend un logiciel de gestion de flotte maritime.
Les cinq autres touchaient des faits commerciaux :
- Towbook s'est vu attribuer un prix de départ mensuel de 49 $ au lieu des 109 $ indiqués sur sa page tarifaire capturée.
- Later s'est vu attribuer un prix de départ de 25 $ au lieu de 18,75 $ par mois en facturation annuelle.
- Ordoro s'est vu attribuer un prix de départ de 299 $ sans nuance, alors que celui-ci s'appliquait au Dropshipping tandis que Shipping démarrait à 0 $.
- Ordoro a été présenté comme n'ayant pas d'offre gratuite, alors que son offre Shipping était annoncée comme gratuite.
- Towbook a été présenté comme offrant un essai de 90 jours, alors que sa page d'accueil indiquait 30 jours.
Nous avons vérifié manuellement chaque contradiction automatisée par rapport aux preuves officielles enregistrées. Onze affirmations ont d'abord été signalées. Huit ont résisté à l'examen.
Le schéma importe davantage que le nombre d'erreurs. Les collisions d'identité nuisent au positionnement de catégorie. Les mauvais prix, offres gratuites et essais changent les décisions d'achat.
C'est l'écart entre le reporting SEO et la réalité du chiffre d'affaires. Une équipe peut célébrer une citation IA alors que la réponse disqualifie discrètement le produit.
Si vous n'avez qu'une heure, auditez d'abord les champs les plus proches d'une décision d'achat : identité de l'entreprise, catégorie, prix de départ, base de facturation, statut de l'offre gratuite, durée de l'essai, intégrations clés et clientèle visée. Ces faits changent plus souvent qu'un nom de marque et comptent davantage qu'un résumé d'entreprise générique.
Les modèles plus récents ont échangé l'abstention contre davantage d'assertions
Nous disposions d'une exécution archivée utilisant GPT 5.2 et Gemini 2.5 Flash sur le même échantillon de 100 entreprises. Ses scores d'origine provenaient d'une passe de jugement différente, nous n'avons donc pas comparé ces scores directement.
À la place, nous avons renoté les 3 923 affirmations archivées et actuelles avec recherche activée à l'aide d'un seul juge Claude Fable 5 en aveugle et des mêmes faits officiels enregistrés. Nous avons ensuite examiné manuellement les 20 signalements de contradiction de cette passe contrôlée.
| Cohorte avec recherche activée | Affirmations | Exactitude vérifiée | Couverture des preuves |
|---|---|---|---|
| GPT 5.2 + Gemini 2.5 Flash | 1 924 | 98,7 % | 64,9 % |
| GPT 5.5 + Gemini 3 Flash | 1 999 | 99,0 % | 55,8 % |

L'exactitude vérifiée a évolué de 0,3 point de pourcentage. Le changement de comportement se situait ailleurs.
Les modèles actuels ont produit 224 assertions substantielles de plus et 149 inconnus explicites de moins. Ils ont davantage répondu et moins esquivé. Dans le même temps, les preuves officielles gelées pouvaient trancher une part plus faible de ce qu'ils disaient. La couverture a chuté de 9,1 points.
Des réponses plus complètes sont plus convaincantes en démo. Elles créent aussi davantage de surface à auditer.
Cela ne prouve pas que les assertions supplémentaires étaient fausses. Cela montre que les points de terminaison plus récents étaient plus enclins à dépasser la limite de nos preuves.
Pour les équipes techniques, le taux d'abstention doit figurer à côté de l'exactitude. Pour les équipes marketing, la longueur et le détail d'une réponse ne sont pas automatiquement synonymes de qualité. Quiconque a validé des textes de campagne générés par IA a déjà appris cette leçon avec moins de décimales.
Une pile de visibilité sérieuse conserve les justificatifs
Un score unique est excellent pour les courbes de tendance et les diapositives de direction. Il est déplorable pour expliquer quoi corriger.
Pour chaque requête surveillée, conservez :
- La requête exacte, la locale, la date, le modèle et le mode de récupération.
- La réponse brute, pas seulement les mentions de marque extraites.
- La présence de la marque, sa position, l'ensemble des concurrents et le sentiment.
- Chaque affirmation produit importante comme enregistrement distinct.
- L'URL source rapportée pour chaque affirmation, lorsqu'elle est disponible.
- La citation de preuve officielle actuelle et l'URL utilisées pour la vérification.
- Un verdict qui préserve les affirmations non résolues au lieu de les écarter.
- L'affirmation et la source précédentes, afin que la dérive soit visible dans le temps.
Si ce modèle de données est trop lourd pour une première passe, commencez par cinq colonnes : requête, affirmation exacte, source rapportée, preuve officielle et verdict. C'est suffisant pour empêcher un agrégat séduisant de masquer un mauvais fait commercial.
Ce modèle de données permet à un responsable growth de demander « pourquoi notre score a-t-il chuté ? » et à un ingénieur de répondre sans ouvrir cinq onglets ni se livrer à de l'archéologie de tableur.
Cela change aussi la file d'actions. Une mention manquée appelle à la distribution ou à une pertinence de catégorie renforcée. Un prix erroné appelle à la correction de la source. Une collision d'identité appelle au nettoyage de l'entité. Ce sont des problèmes différents portant la même couleur de tableau de bord.
Ce que les marketeurs peuvent corriger avant le prochain crawl
Vous n'avez pas besoin de corriger tout l'internet. Commencez là où le risque pour l'acheteur et votre maîtrise se recoupent.
Rédigez une phrase d'entité d'une clarté ennuyeuse. En haut de la page d'accueil, dites ce qu'est l'entreprise, qui elle sert et ce qu'elle fait. Gardez le slogan astucieux. Ne lui demandez simplement pas de porter tout le graphe de connaissances.
Donnez aux faits commerciaux un foyer canonique unique. Le prix de départ, la base de facturation, le statut de l'offre gratuite et la durée de l'essai doivent être un texte à jour et crawlable. Les pages tarifaires sont l'endroit où les stratégies d'entité propres vont mourir : remises annuelles, bascules masquées, règles régionales et anciens articles d'aide se disputent tous l'autorité.
Nettoyez les copies tierces obsolètes. Recherchez le nom de l'entreprise avec son domaine, sa catégorie, sa tarification et ses termes d'essai. Passez en revue les annuaires, les marketplaces, les pages de produits rachetés, les anciens articles de lancement et les profils d'avis. Le modèle répète peut-être une source que l'équipe marketing a oubliée depuis trois changements de marque.
Surveillez les requêtes d'acheteurs, pas les requêtes de vanité. Suivez les questions de catégorie, d'alternative, de comparaison, de tarification, d'intégration et de cas d'usage. « Qu'est-ce qu'Acme ? » est plus facile à répondre correctement que « Quelle offre Acme convient à une équipe sécurité de 20 personnes ? » La seconde requête est plus proche du chiffre d'affaires.
Ouvrez la réponse avant de célébrer la mention. Le nombre de citations est une métrique de découverte. L'exactitude des affirmations est une métrique de confiance. Vous avez besoin des deux. Un suivi de visibilité flux de travail devrait conserver la requête, la réponse brute, les sources, les preuves et les changements entre les exécutions.
Ce travail est moins passionnant que publier 50 pages sur l'avenir du GEO. Il est aussi plus susceptible d'empêcher un modèle de citer le prix de l'année dernière.
Réalisez cet audit d'affirmations en 30 minutes
Vous pouvez tester la couche des affirmations avant d'acheter une nouvelle plateforme ou de demander un pipeline à l'ingénierie.
- Choisissez cinq requêtes d'acheteurs. Utilisez une requête de catégorie, une comparaison, une question de tarification, une question d'intégration et une question de cas d'usage.
- Exécutez chaque requête dans deux moteurs de réponse. Utilisez une session propre, enregistrez le nom du modèle et la date, et copiez la réponse complète.
- Surlignez les affirmations décisives pour l'acheteur. Marquez chaque déclaration sur la catégorie, le prix, l'offre, l'essai, l'intégration, la sécurité, la clientèle visée ou la capacité produit.
- Vérifiez le justificatif. Ouvrez la source rapportée, puis comparez l'affirmation avec la page officielle actuelle. Marquez-la comme étayée, contredite ou non résolue.
- Attribuez la correction. Mettez à jour une page possédée, corrigez un profil tiers, clarifiez le langage d'entité, ou gardez l'affirmation sur une liste de surveillance pour la prochaine exécution.
Utilisez un tableau simple. Le but est d'apprendre, pas de fabriquer un score d'apparence sophistiquée.
| Requête | Affirmation exacte | Source rapportée | Preuve officielle | Verdict | Correction suivante |
|---|---|---|---|---|---|
| Meilleurs outils pour [cas d'usage] | [Copiez la phrase] | [URL ou aucune] | [URL actuelle et citation] | Étayée / contredite / non résolue | Possédée / tierce / à surveiller |
Dix réponses suffisent à révéler si votre problème immédiat est la présence, le sourcing, l'exactitude factuelle ou l'absence de preuves officielles. Vous n'aurez pas de benchmark de marché. Vous aurez quelque chose de plus utile pour la prochaine journée de travail : une liste de corrections classée par ordre de priorité.
Méthodologie pour ceux qui se méfient des benchmarks
Bonne intuition.
L'échantillon comprenait 100 entreprises de logiciels B2B de 1 à 200 employés aux États-Unis, au Canada, au Royaume-Uni et en Australie. Chacune des quatre tranches de taille a contribué pour 25 entreprises.
Une entreprise n'entrait dans le benchmark que si son site officiel était en ligne, correspondait à l'entreprise et fournissait au moins quatre faits vérifiés par preuve. Nous avons capturé un ensemble délimité de pages d'accueil, produit, fonctionnalité, tarification, intégration et à propos. Un fait ne comptait que si son URL officielle et la citation à l'appui correspondaient au texte de la page capturée.
Chaque modèle a reçu la même requête d'acheteur datée contenant le nom de l'entreprise et son domaine. Il n'a pas reçu le profil de preuves. Nous avons recueilli une réponse par entreprise le 15 juillet 2026.
Nous avons découpé chaque réponse en affirmations et attribué l'un des quatre verdicts : étayée, contredite, non vérifiable ou non-affirmation. Une preuve manquante ne comptait pas comme une contradiction.
Une famille de modèles distincte a renoté 563 affirmations issues de 20 entreprises. Elle était d'accord avec la passe principale sur 528 affirmations, soit 93,8 %. L'examen humain a ensuite ramené les 11 signalements de contradiction automatisés de la passe principale à huit erreurs confirmées.
Les limites sont réelles :
- Une réponse par entreprise ne permet pas de mesurer la variance des réponses.
- L'échantillon couvre des entreprises de logiciels B2B plus petites sur quatre marchés anglophones, pas l'ensemble du secteur du logiciel.
- Notre capture des pages officielles était délimitée. Certaines affirmations non résolues peuvent être étayées sur des pages que nous n'avons pas capturées.
- Une URL rapportée ne prouve pas la récupération ni la dépendance.
- Claude Fable 5 ne disposait pas d'une récupération web native équivalente, il a donc été exclu des métriques principales avec recherche activée.
- Les échantillons de champs commerciaux étaient petits. Lisez les effectifs avant de répéter le taux.
Le score vert est le début de l'enquête
Le résultat de 98,6 % est une bonne nouvelle. Lorsque nos preuves pouvaient trancher une affirmation, les modèles avec recherche activée avaient généralement raison.
Le résultat de couverture de 39,5 % est l'avertissement. Six affirmations substantielles sur dix se trouvaient hors des preuves que nous pouvions confirmer ou réfuter. Certaines étaient probablement correctes. Certaines ont révélé un contenu web manquant ou contradictoire. Huit étaient fausses d'une manière susceptible de changer une décision d'achat.
La visibilité IA n'est pas une seule métrique. C'est une chaîne allant de la requête à la mention, puis à l'affirmation, à la preuve et au changement dans le temps.
Si votre pile actuelle s'arrête aux mentions, gardez-la. Vous avez déjà la couche de présence. Ajoutez une revue des affirmations pour les cinq requêtes à plus forte intention avant d'étendre le programme. Un petit audit avec des preuves visibles est plus utile qu'un score d'apparence complète que personne ne peut interroger.
La présence fait entrer la marque dans la réponse. L'exactitude garde la réponse digne d'être lue.
La mention est un prospect. L'affirmation est le risque. La preuve est le travail.